Tecnologías de la información
Administración de archivos, grupos, comandos.
Sistemas Operativos / Linux
En estos ejercicios importa distinguir el nombre del archivo, su inodo y los permisos que afectan cada operación. La terminal responde a reglas concretas, aunque a veces parezca que negocia con entidades antiguas. (ಡωಡ)
Linux posee distintas maneras de moverse entre archivos y para la administración de grupos, usuarios, permisos y procesos.
En este apartado, ejecutaré algunos comandos a modo de ejercicio.
Para esto utilizaremos la versión de Ubuntu usada al realizar el ejercicio (no necesariamente la más reciente hoy), montada en virtualbox.
Tabla de contenidos
Manejo de archivos y directorios
1.- Creación de archivos y enlaces
En este apartado:
- Crearemos un archivo
- Agregaremos contenido
- Crearemos un enlace duro apuntando a dicho archivo
- Notaremos los inodos
- Anotaciones adicionales
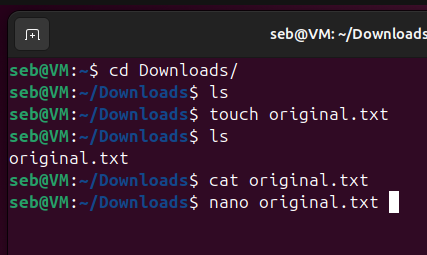
- Haremos
cd Downloads/para movernos a la carpeta Downloads lspara listar que la carpeta esta vaciatouch original.txtcon touch le indicamos que crearemos un archivo con el nombre original.txtlsnuevamente para checar que esté nuestro archivocat original.txtpara revisar que el archivo esté vacíonano original.txtpara editar original.txt usando el editor nano
Se nos abrirá nano, un editor de texto en el terminal.
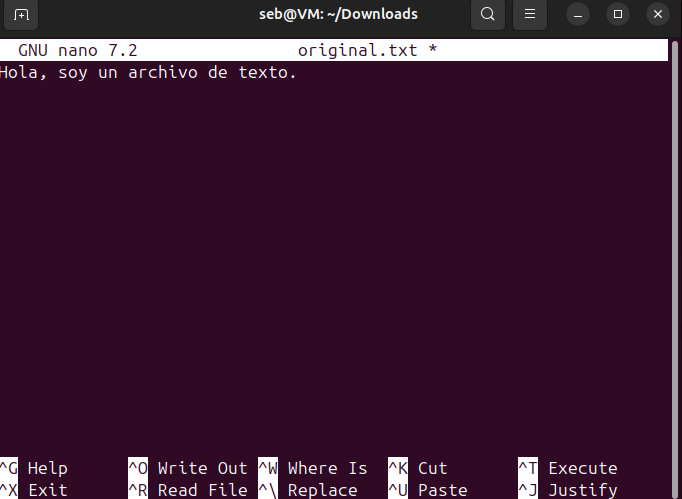 Posteriormente le damos a
CTRL + X en el teclado para cerrar, escribimos Y para aceptar los cambios y presionamos ENTER para que se guarde con el mismo nombre.
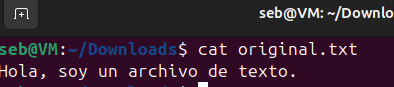
Posteriormente haremos nuevamente cat original.txt para ver que se haya guardado correctamente:
Ahora crearemos un enlace duro y listaremos los inodos y permisos.
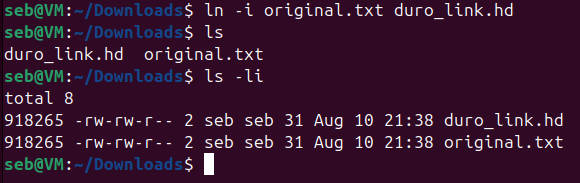
ln -i original.txt duro_link.hdpara creaciónlspara revisar su existencials -lipara listar inodos, permisos e información relevante. Aquí podemos notar que ambos archivos son exactamente iguales, tanto el inodo, permisos y fecha de creación pero su nombre es distinto.
Un inodo es una estructura de metadatos; su número es único dentro de un sistema de archivos mientras está asignado, no globalmente ni para siempre. ls -l suele mostrar modificación, no creación.
El enlace duro es un alias para un archivo. Es decir, es otra forma de acceder al mismo inodo.
En este caso, duro_link.hd y original.txt, lo que están haciendo ambos es acceder al inodo 918265, con nombres diferentes.
Originalmente pensaba que eran lo mismo que los enlaces simbólicos (soft links - accesos directos) pero investigando un poco más encontré una analogía buenísima: ==Los enlaces duros son dos números de teléfono distintos para la misma linea, mientras que un enlace simbólico son dos lineas diferentes para la misma casa==. Esto quiere decir que un enlace duro de un archivo es el mismo archivo (inodo), accedido con otro nombre. Pero un enlace simbólico es otra forma de acceder a un archivo con un inodo diferente.
Las ventajas de un enlace duro parecen superiores ya que son más rápidos al apuntar al mismo inodo, pero no pueden cruzar sistemas y no pueden apuntar a directorios. En cambio los enlaces simbólicos son más flexibles en ese sentido pero se pueden romper más fácilmente.
Los enlaces duros pueden ser ideales cuando necesitamos múltiples nombres para un mismo archivo dentro del mismo sistema y queremos darle mayor seguridad a que el archivo no será accidentalmente borrado.
¿Qué pasa si elimino el archivo original? Si elimino el nombre original, los demás enlaces duros siguen funcionando: todos apuntan al mismo inodo. El sistema puede liberar el archivo cuando ya no quedan enlaces duros ni procesos que lo mantengan abierto.
2.- Modificación
En este apartado:
- Modificaremos el archivo original.txt
- Mostraremos el contenido de duro_link.hd
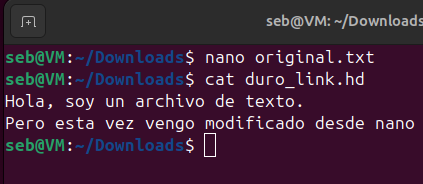 Como podemos ver, las modificaciones hechas en el archivo
original.txt, también se ven reflejadas enduro_link.hd. La explicación es la misma que hice aquí. Ambos son el mismo archivo, pero accedidos de distinta forma.
3.- Eliminación y enlaces
En este apartado:
- Eliminaremos original.txt
- Mostraremos su contenido desde duro_link.hd
- Verificación de su estado
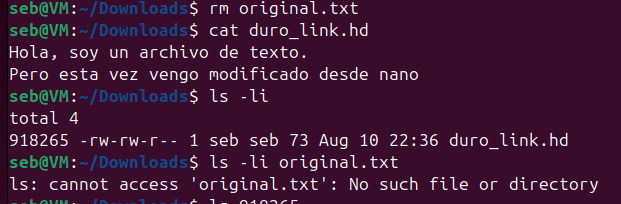
rm original.txt: eliminamos original.txtcat duro_link.hd: comprobamos que el contenido sigue siendo el mismols -li: verificamos qué hay en la carpeta.
Si bien, eliminamos el archivo original, su enlace duro sigue estando ahí. Como mencioné aquí, aplica el mismo concepto. Su inodo sigue existiendo y es a eso a lo que estamos apuntando.
4.- Enlaces simbólicos
En este apartado:
- Crearemos un nuevo archivo: example.txt
- Crearemos un enlace simbólico que apunte a example.txt
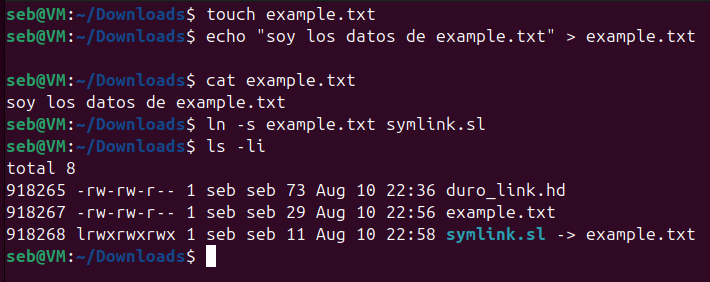
touch example.txt: creamos example.txtecho "texto" > example.txt: echo para darle el texto,>para indicarle que la salida es hacia example.txtcat example.txt: para verificar su contenidoln -s example.txt symlink.sl: Creamos un enlace, con el argumento-sle indicamos que es un enlace simbólicols -li: listamos la información de la carpeta.
Aquí podemos notar que los inodos de example y symlink son distintos. Además, podemos corroborar que los permisos son diferentes, incluye una l que indica que es un enlace simbólico, tiene fechas distintas y además symlink.sl -> example.txt nos indica que este archivo está apuntando a otro.
Con esta información podemos concluir definitivamente que un enlace simbólico es diametralmente diferente a un enlace duro.
5.- Eliminación e impacto en enlace simbólico
En este apartado:
- Eliminaremos example.txt
- Comprobaremos el contenido a través de su enlace simbólico
- Verificar estado
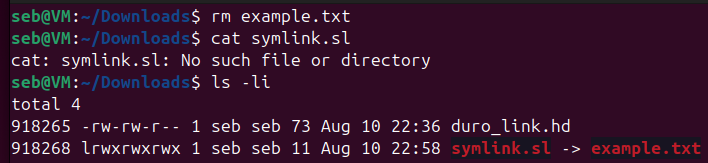
rm example.txt: eliminamos examplecat symlink.sl: revisamos el contenido, notamos que indica que el archivo no existels -li: El archivo en realidad está ahí pero ahora su dirección apunta en rojo.
¿Qué ocurre?, los enlaces simbólicos al apuntar hacia otros archivos, no funcionan por sí solos. Es por esto que me arroja que el archivo no existe, porque en realidad me está diciendo que el archivo al que apunta, no existe. Aquí nuevamente podemos compararlo con mi respuesta previa. Los enlaces simbólicos apuntan al archivo y no al inodo como lo hacíamos con los enlaces duros.
6.- Find e importancia de logs
En este apartado:
- Con find buscaremos los archivos .log en un directorio particular
- Crearemos copias a un nuevo directorio
- La importancia de los logs
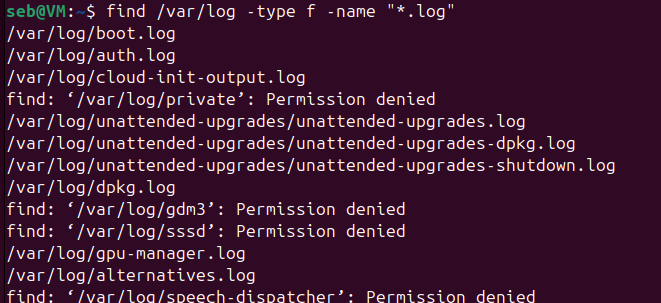
find /var/log -type f -name "*.log": iniciamos la búsqueda de los archivos log
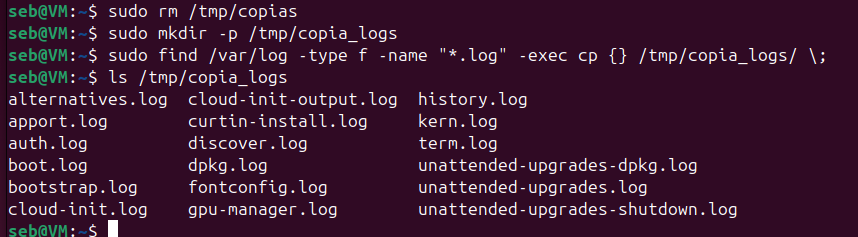
sudo rm /tmp/copias: el método que utilicé originalmente me creó un archivo binario que sólo podía eliminar de esta formasudo mkdir -p /tmp/copia_logs: creamos el directorio dentro de la carpeta tmpsudo find /var/log -type f -name "*.log" -exec cp {} /tmp/copia_logs/ \;: básicamente busca los archivos y por cada archivo que encuentre ejecuta el comandocpls /tmp/copia_logs: revisamos que estén las copias de los archivos.
Crear copias de los logs es crucial para mantener la integridad de los mismos. Una copia no demuestra integridad ni disponibilidad permanente. Registrar origen, tiempos y hashes verificables, proteger acceso y probar recuperación; copiar a /tmp es temporal y no un backup durable. En este enlace de mis apuntes, hablo un poco sobre logs
7.- Comando de búsqueda
En este apartado:
- Comando para buscar archivos mayores a 5MB, listando sus nombres y tamaños
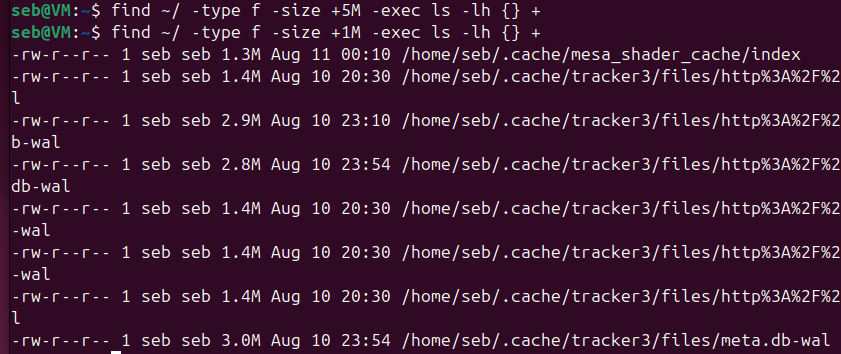
find ~/ -type f -size +5M -exec ls -lh {} +: Con este comando encontramos todos los archivos mayores a 5MB, pero dado que es una instalación fresca, no encontrará nada así que realizamos el siguiente:find ~/ -type f -size +1M -exec ls -lh {} +: Es el mismo comando pero cambiamos que sea mayores a 1MB. Esto nos despliega como resultado los permisos, el autor, dueño, tamaño, fecha de modificación y localización, pero creo que podría mejorarse.
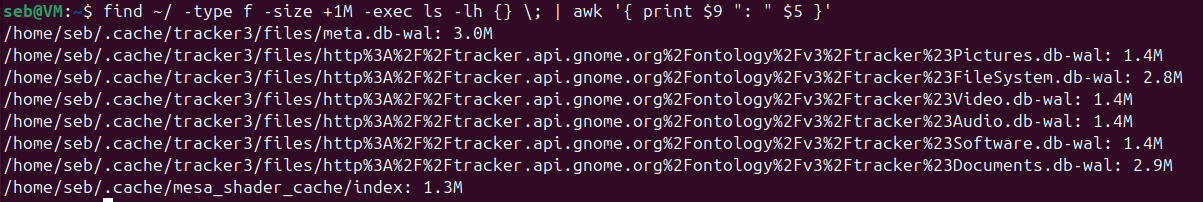 Este comando es similar, pero un poco más complejo. El resultado de
find se lo pasamos (|) a awk (un lenguaje de programación interno de linea de comandos usado para procesar y analizar textos), luego imprimimos (print) los parámetros $9 y $5 concatenando un : entremedio.
La utilidad de este tipo de comandos es útil a la hora de tomar respaldos, de administrar el espacio, ayuda a hacer mantenimiento de los computadores y ayuda a identificar archivos obsoletos, con esto podemos fácilmente identificar archivos problemáticos, podriamos combinarlo con otros comandos para automáticamente eliminar todos los archivos mayores que un determinado tamaño o podriamos generar un informe con ello.
Usuarios y grupos
1.- Creación de usuario
En este apartado:
- Crear un usuario con una ID determinada con shell bash
- Crear otro usuario, pero con shell no interactivo
- Un tercer usuario con shell zsh
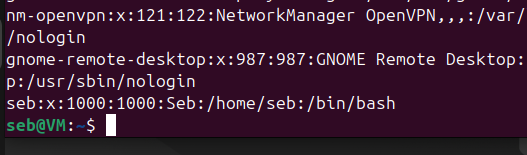
cat /etc/passwd: Primero corremos este comando para verifiar los usuarios actuales. Los primeros usuarios que lista son todos internos de sistema, el último es el usuario que cree para usar ubuntu.
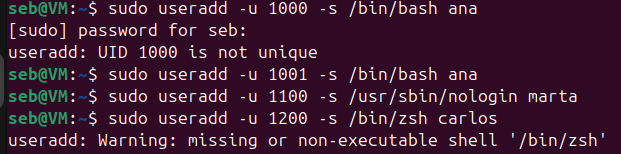
sudo useradd -u 1000 -s /bin/bash ana: sudo, creamos nuevo usuario, le pasamos el id y le decimos que shell usar. En este caso nos encontramos con un error porque el id 1000 ya estaba en uso por el usuario por defecto (seb)sudo useradd -u 1001 -s /bin/bash ana: Cambiamos el id 1000 por el 1001 y esta vez si funcionasudo useradd -u 1100 -s /usr/sbin/nologin marta: Mismo proceso pero le damos id 1100 y especificamos usar no-login.sudo useradd -u 1200 -s /bin/zsh carlos: Mismo proceso, id 1200 pero nos topamos con que no es posible ya que no existe zsh. Procedemos a su instalación.
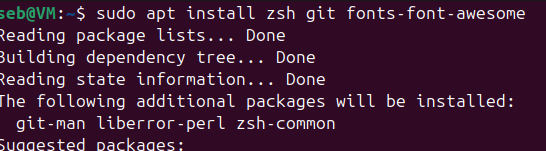
sudo apt install zsh git fonts-font-awesome: sudo, apt install para installar zsh, además le damos parametros adicionales para instalar fuentes que podrían ser útiles para configurar zsh en un futuro.sudo useradd -u 1200 -s /bin/zsh carlos: Lo ejecutamos pero me dice que el usuario ya existe así que lanzamos...cat /etc/passwd: Para leer nuevamente los contenidos de passwd, listar usuarios y obtenemos: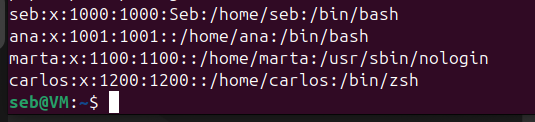 Con esto ya confirmamos que están los 3 usuarios creados y con un shell asignado.
Como anotación sobre los shells, me parece importante mencionar:
bashes el CLI por defectonologinbásicamente crea un usuario sin login, útil para usuarios que no lo necesitanzshes similar abashpero con más características y funciones, es un bash con esteroides.
2.- Creación de grupos
En este apartado:
- Crearemos 3 grupos diferentes.
- Asignaremos a los 3 usuarios a dichos grupos.
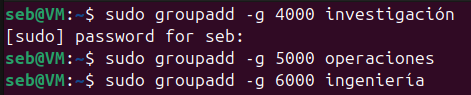 Corremos el mismo comando modificado 3 veces para así crear los grupos:
sudo groupadd -g idgrupo nombregrupo
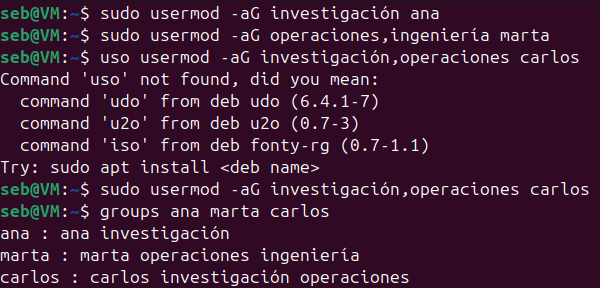 Ejecutamos:
sudo usermod -aG grupo usuario: Ejecutamos este comando tres veces cambiando los parámetros de grupo y usuariouso (...): comando mal escritogroups ana marta carlos: Listamos los grupos de cada usuario.
Con este proceso hemos agregado a cada usuario a un grupo distinto.
3.- Listar usuarios
En este apartado:
- Listamos la información de cada usuario
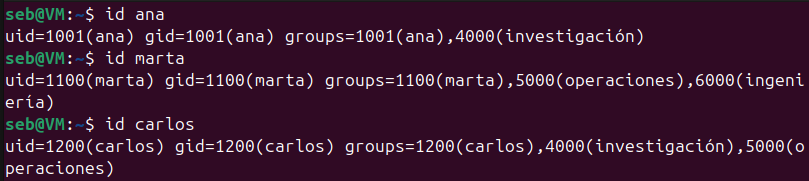 Ejecutamos el comando
idcon cada usuario. Recibimos: uid: user idgid: group idgroups
Lo primero que noté es que además de los grupos que le entregué yo a cada uno, cada usuario tiene un grupo personal con la misma id que el usuario. Esto se debe a que la mayoría de las distros modernas de linux existe el concepto de
UPGo User Private Group. Cuando creamos un usuario nuevo, se le asigna automáticamente a un grupo privado del mismo usuario, de modo que los archivos que este crea, sean sólo de su autoría y no de un grupo común, para así evitar problemas de integridad.
Ahora, listaremos además los usuarios con grep.
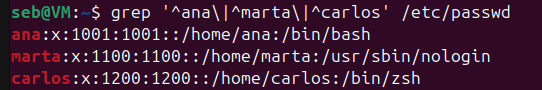 La salida que nos entrega grep es
usuario:contraseña:uid:gid:comentario:rutaHome:shell.
La x suele indicar que el verificador está en /etc/shadow: es un hash de contraseña, no la contraseña cifrada ni el hash mismo, como no tenemos comentarios de usuario sólo aparece como :: sin nada entremedio.
4.- Listar grupos
En este apartado:
- Listaremos la información de los grupos.
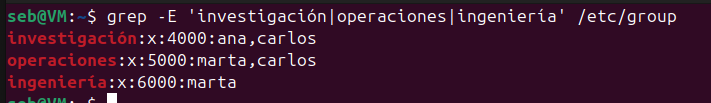 Obtenemos
grupo:x:gid:usuarios. Es similar a lo que obtenemos de usuarios, laxes un marcador, no una contraseña cifrada; el campo y su uso dependen de la configuración de grupos/gshadow.
Procesos
1.- Formas de revisar procesos
En este apartado:
- Revisaremos los procesos activos en el sistema con diferentes comandos
- Analizaremos las ventajas, desventajas y diferencias de cada uno.
PS
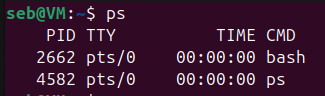
ps: Muestra un snapshot o instantánea de los procesos. Veo que es más limitado sin argumentos pero si le pasamos aux es mucho más completo
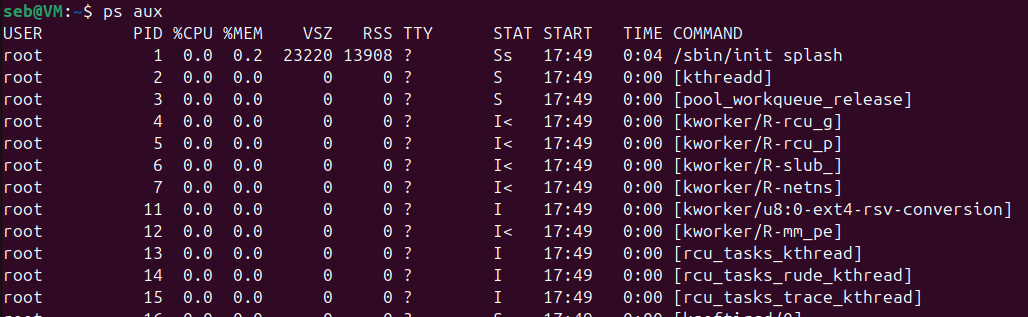
ps aux
PSTREE
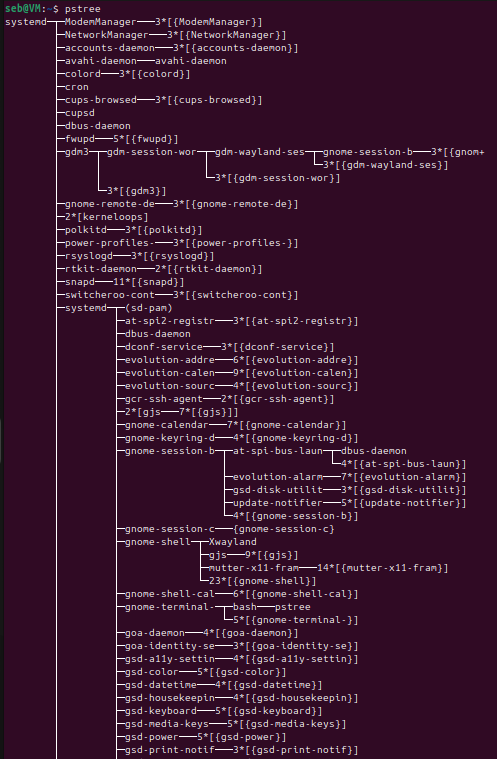
pstree: Muestra los procesos como un árbol, podemos ver qué proceso responde a qué o su relación padre-hijo.
TOP
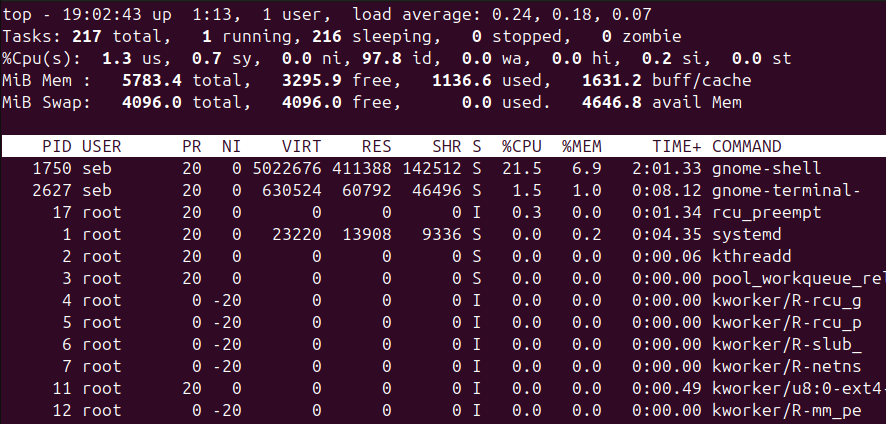
top: Funciona en tiempo real, y se va actualizando constantemente como un monitor. Similar al administrador de tareas de windows.
HTOP
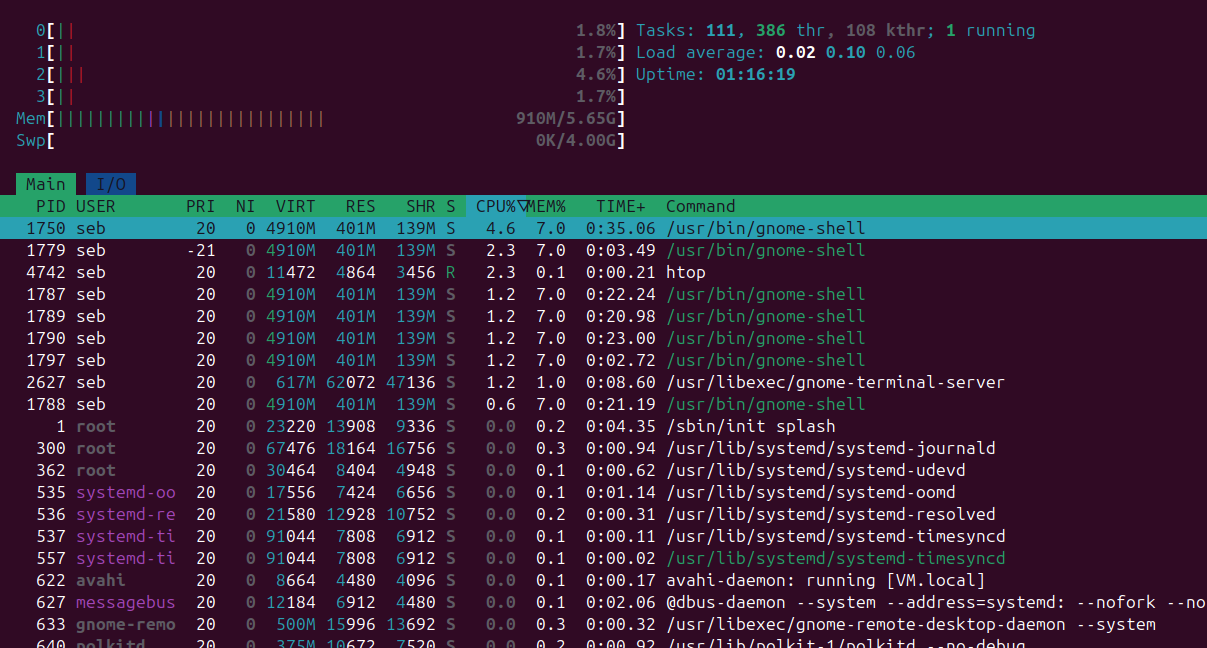
htop: No viene por defecto pero lo instalamos rápidamente con sudo apt install htop. Es más completo que top.
Cada uno de los comandos utilizados tiene su propia ventaja y desventaja.
pssirve para mostrarnos un "pantallazo" de los procesos, es más limitado en ese sentido pero podemos recibir más información con más argumentos.pstreetambién nos muestra un pantallazo, es bueno mostrándonos la jerarquía pero no nos muestra, por ejemplo, el uso de recursos.toptop si nos muestra el uso de recursos en tiempo real pero su interfaz es poco amigable e intuitivahtopes ahí donde entra htop que sí es más visualmente intuitiva. tenemos distinciones de colores (que ya es una gran diferencia).
2.- Suspensión de procesos
En este apartado:
- Abriremos un nuevo proceso
- Lo suspenderemos y verificaremos su estado
- Será reanudado y luego terminado de forma adecuada.
Ejecutamos vi para abrir Vim y presionamos CTRL + Z

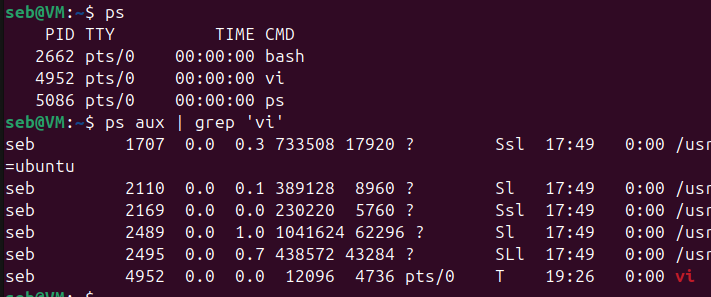
 Ejecutamos:
ps: solo con este comando no logramos identificar si el proceso está suspendido, nos falta más información.ps aux | grep 'vi': Ahora sí podemos ver en el id 4952 que Vi está con estado 'T' que significa suspendido.ps aux | grep -w vi: Un grep más acotado para que no me muestre coincidencias parciales.
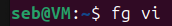 Utilizamos el comando
fg nombre. En este caso, fg era suficiente, esto trae el proceso suspendido más reciente, pero es bueno tener en cuenta que si tenemos más de uno, usar un jobspec válido, por ejemplo fg %1 tras consultar jobs; no un PID arbitrario.
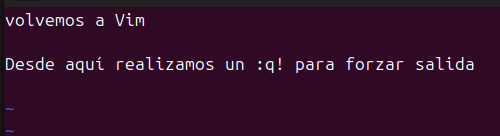
Realizamos nuevamente ps y notamos que Vi ya no está activo.
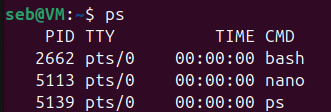
De pasada, aprovecharemos de cerrar forzosamente nano
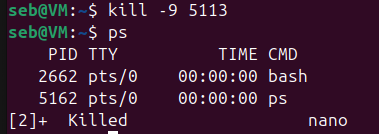
kill -9 5113
3.- Relaciones jerárquicas
En este apartado:
- Relaciones jerárquicas con
ps
Para mostrar las relaciones de jerarquía que tienen los procesos, usando ps, le pasamos los argumentos fax, cada uno de ellos hace algo diferente:
f(opción BSD sin guion) muestra una jerarquía tipo árbol;-fes otra opción, de formato completo.anos muestra los procesos de todos los usuariosxmuestra los procesos que no están asociados a una terminal, como procesos en segundo plano.
Ejecutamos ps fax
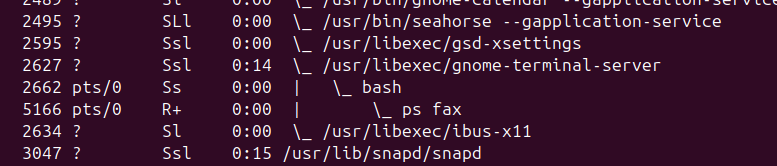 Aquí podemos ver en el proceso 2627 que:
/usr/libexec/gnome-termina-serveres el proceso de donde sale la terminal, esta es padre debashque es la terminal, y este a su vez es padre deps faxque es el comando que estamos viendo.- Cada indentación muestra la jerarquía.
Ejecutamos ps -ejH
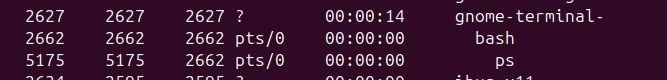 Este es un comando similar con la diferencia que:
- Nos muestra los procesos como árbol compacto
emuestra todos los procesos sin importar el usuariojmuestra información sobre el grupo de procesos, incluyendo su idHle otorga la cualidad de mostrarlo con el árbol de jerarquías.
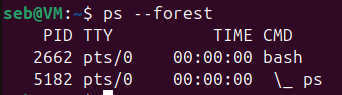
También, similarmente tenemos ps --tree que no está disponible siempre pero muestra sólo los procesos activos del usuario, omitiendo los procesos en segundo plano.
4.- Backups y Cron
En este apartado:
- Crearemos una tarea de automatización con cron
- Automatizar backup de documentos
Para esto tenemos 2 alternativas:
- Crear un script, el cual sea ejecutado por crontab
- Crear la tarea dentro de crontab.
Con tareas complejas la primera opción es la ideal, por lo tanto la segunda opción es la más adecuada, pero por fines educativos haremos ambas.
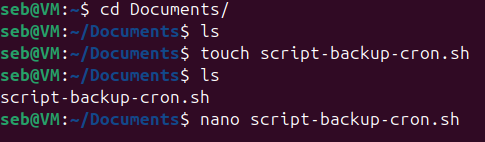
lspara notar que no hay nada en/Documentstouch script-backup-cron.shpara crear un script de bashlsnuevamente para ver su creaciónnano script-backup-cron.shpara editar el archivo.
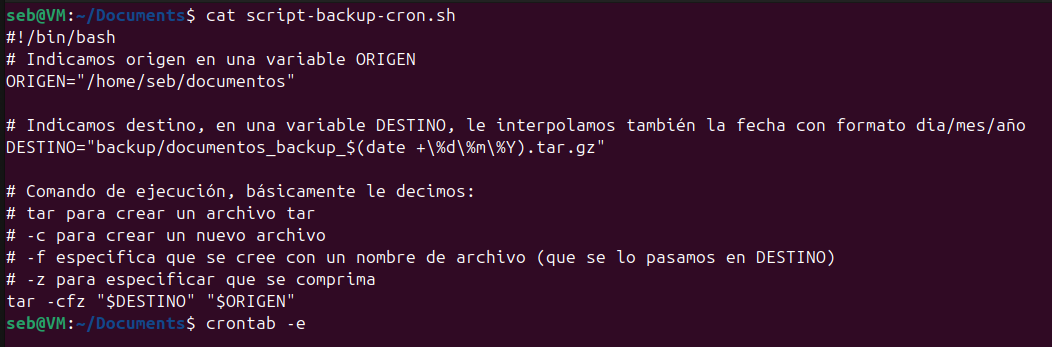
cat script-backup-cron.shmostramos el contenido, ahí podemos ver el script que hice.crontab -elanzamos el -editor de crontab.
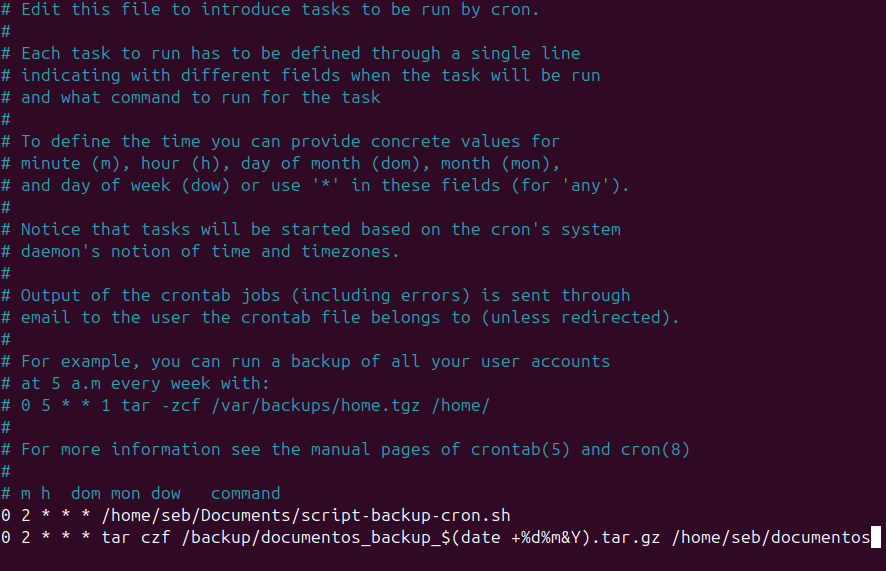
- Crontab no es más que un archivo con instrucciones en texto
- Dentro del mismo archivo están las instrucciones de uso.
La configuración va así:
- hora, día, comando.
- hora está dividido en minutos, horas
- día está dividido en día del mes, mes, día de la semana
- se pueden usar asteriscos
*para indicar que sean "todos" - el comando a ejecutar puede ser un linkeo externo (como la primera línea que ejecuta el script indicado)
- el comando puede ser dentro de la misma linea (como la segunda línea)
Es importante automatizar ciertos procesos para disminuir el error humano y mejora la eficiencia. Mientras menos tenga que intervenir el usuario en tareas repetitivas, menos espacio dejas para errores por negligencia. Es también importante realizar backups constantes de archivos importantes, como mencionamos en este apartado. Cron es una poderosa herramienta para automatizar los procesos más tediosos pero importantes. Nos permite automatizar tareas según frecuencia en horas, días o incluso meses. Las entradas persistidas vuelven a programarse si cron arranca, pero cron normal no recupera por sí solo las ejecuciones perdidas mientras el equipo estaba apagado. Además es bastante sencillo de utilizar.
5.- Automatización de un reporte de monitoreo e importancia.
En este apartado:
- Crear una tarea de cron que automatice un proceso
- Dicho proceso tendrá una salida que se guardará en un archivo
- Importancia del monitoreo de recursos
Nuevamente podemos realizarlo a través de un script o directo a Cron.
En esta oportunidad, con un script es una tarea más compleja pero de todas formas haremos ambos.
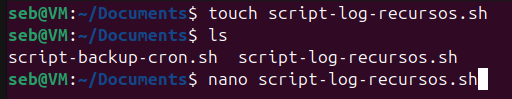 Creamos el archivo, listamos y lo editamos con nano.
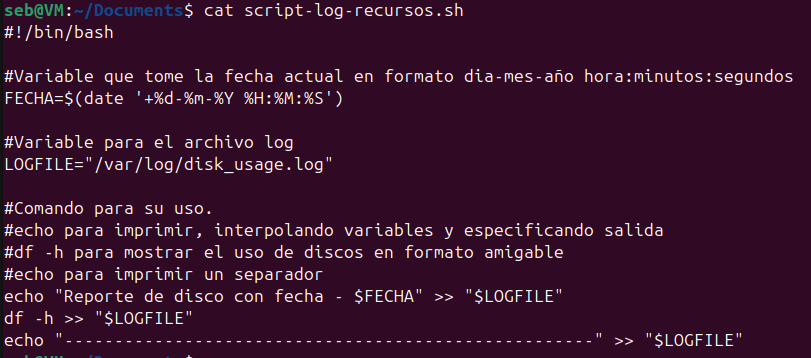 Creamos el script.
Ahora vamos a linkearlo en crontab
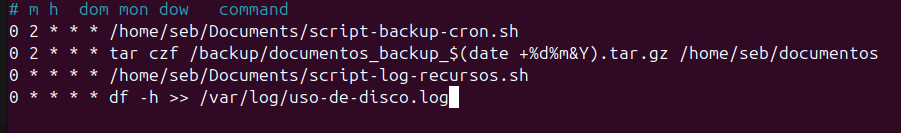 En la 3ra linea tenemos el linkeo del script, similar al de la linea 1.
En la 4ta linea tenemos el comando directo.
Ahora, la forma dentro de crontab puede sonar tentativa por simplicidad pero es importante mencionar que es menos modificable. Si quisiéramos hacer lo mismo que en el script, tendríamos una linea más compleja con información, la cual puede resultar difícil de leer si tenemos muchas automatizaciones.
Monitorear regularmente los recursos del sistema es importante para detectar anomalías y mantener un ojo en cuando podemos necesitar una mantención. También nos ayuda a analizar el rendimiento, reconocer cuándo el disco se llenará y así tomar acciones preventivas. También es importantísimo al momento de cumplir normativas de una empresa o para análisis forenses.
Similar a crontab también tenemos nagios que nos puede ayudar a levantar alertas para ello. Grafana también es uno muy útil ya que nos puede mostrar visualizaciones para hacer más legible la información.
Conclusión
El manejo de herramientas y comandos en Linux es esencial para lograr un desempeño óptimo en la administración. Aunque Linux es conocido por su curva de aprendizaje y su interfaz menos amigable en comparación con otros sistemas operativos más populares, sus ventajas se hacen evidentes a medida que nos familiarizamos con sus capacidades.
El uso de herramientas como cron facilita la automatización de tareas, permitiendo una gestión eficiente y programada de procesos repetitivos, como backups y reportes. Esto no solo ahorra tiempo, sino que también minimiza el riesgo de errores humanos y asegura la consistencia en las tareas de mantenimiento del sistema.
Además, comandos como grep resultan fundamentales para el filtrado y la búsqueda de información específica en el sistema, mejorando la eficiencia. A través de estos ejercicios, hemos desarrollado habilidades prácticas en la administración de Linux y hemos obtenido una comprensión más profunda del sistema. La capacidad de gestionar procesos, configurar tareas y realizar monitoreo de recursos proporciona una base sólida, destacando las fortalezas y flexibilidad de Linux en comparación con otros entornos.
Anexo: Comandos utilizados
cd: Change directory, cambiar de directoriols:lslista los archivos y directorios dentro de un directorio. El argumento-lidice:l: Mostrar información de permisos, propietario, grupo, tamaño, fecha de modificación y nombrei: Mostrar el inodoh: lo hace "humanamente legible", es decir, transforma los tamaños de sólo a bytes a un formato más legible
ln: Link, linkea un archivo a otro, creando un enlace duro.-s: indica que es un enlace simbólico
touch: Crea un archivo nuevocat: Concat. Nos muestra los contenidos o concatena archivosnano: Abre nano, el editor de texto en el CLI.useradd: Agregar usuario.-u: para asignarle una ID-s: para indicarle un shell a utilizar
apt: Comando para realizar acciones sobre aplicacionesinstall: con esto le indicamos aaptque queremos instalar un nuevo paquete
groupadd: Creamos un nuevo grupo.-g: para especificar la id, ya sea al momento de crearlo o asignarlo
usermod: Modificar usuario-a: append. indica que se debe agregar x a y-G: Indica el grupo. Por lo tanto, al usarlo como-aGle decimos que debe agregar al grupo
groups: Comando para listar los grupos a los que pertenece el usuario actual (sin parámetros) o a los de los usuarios que le pasamos.id: Muestra información detallada sobre usuario.grep: comando para buscar y filtrar texto dentro de archivos o resultados de otros comandos. Significaglobal regular expression print- 'Impresora global de expresiones regulares'- Al ser un comando de expresiones regulares, los parámetros son diversos.
- Una buena página para practicar y aprender expresiones regulares
echo "texto" > example.txt: Echo es un comando para mostrar texto en el terminal. Literalmente hace "eco" de lo que le decimos.>: se llama redirección de salida, con esto le indicamos que lo que entrega echo, sea redirigido al archivo example.txt
rm: Remove. Literalmente remover, eliminar.find /donde/ "que": Buscar.-name: especifica que estamos buscando archivos a través de su nombre.-type: especifica que estamos buscando archivos según un tipo, le entregamosfpara decirle que busque solofiles
awk: lenguaje interno utilizado para procesar texto.sudo: super user do. Ejecutar el siguiente comando con privilegios elevados.ps: Process status. Muestra un snapshot de los procesosauxmuestra todos los procesos con detalles.- podemos combinarlo con
grepa través de un pipe|para filtrar y destacar
pstree: Muestra snapshot de los procesos en formato de árbol, con las jerarquías padre-hijotop: Muestra procesos en tiempo real detallando uso de recursoshtop: Lo mismo quetoppero con un formateo más amigable y otras funcionalidades adicionales.fg: Foreground. Trae el proceso más recientemente suspendido de vuelta.kill pid: "mata" un proceso o lo termina. Sin argumentos le envía una señal 15 (de terminación), lo cual le da tiempo para cerrar y limpiar. En este caso de uso le dimos -9 y 5113 donde -9 le da la orden de terminarlo sí o sí y 5113 es el pid (process id).- Importante notar que nano no se cerraría con
kill 5113al estar suspendido.
- Importante notar que nano no se cerraría con
crontab: Usar crontab, el argumento-eabre la edición de sus parámetros.
Véase también
- Comandos — Referencia de comandos utilizados en el laboratorio.
Contraste: passwd(5), job control de Bash. Un symlink guarda una ruta; no es otra línea para la misma casa en sentido técnico. Sustituir un archivo mediante rename puede romper la expectativa de edición compartida de un hardlink. %/jobs pertenecen al shell; vi no siempre es Vim. ps --forest controla formato, no elimina procesos en background. Un proceso detenido puede tener SIGTERM pendiente hasta continuar; preferir cierre normal antes de SIGKILL. Copiar logs a un solo directorio puede sobrescribir nombres repetidos; preservar estructura y metadatos. Un backup automático necesita comprobar integridad, retención y restauración, además de la ejecución programada.
+----------------------------------------+
| Floure &                               |
| Tachibana's guild                      |
| [Hikari · Nozomi · Vesper]             |
| SEAL: sha256/12: fb40533a37ff          |
| STATUS: LITURGY_IN_PROGRESS            |
+----------------------------------------+